Spark AQE가 셔플 뒤 실제 크기로 다시 정하는 것들
같은 stage의 태스크 대부분이 금방 끝나는데 몇 개만 오래 붙잡혀 있다면, 원인은 보통 셔플 파티션 하나에 데이터가 몰린 것이다. 연말 결산 글의 잡들은 1년 치 재생 로그를 RANK() OVER (PARTITION BY user_id ...)로 사용자마다 순위를 매겼다. 이런 쿼리는 셔플이 어디서 생기는지, 파티션 하나가 얼마나 커지는지에 따라 ...
같은 stage의 태스크 대부분이 금방 끝나는데 몇 개만 오래 붙잡혀 있다면, 원인은 보통 셔플 파티션 하나에 데이터가 몰린 것이다. 연말 결산 글의 잡들은 1년 치 재생 로그를 RANK() OVER (PARTITION BY user_id ...)로 사용자마다 순위를 매겼다. 이런 쿼리는 셔플이 어디서 생기는지, 파티션 하나가 얼마나 커지는지에 따라 ...
Airflow 태스크는 한 번만 돈다는 보장이 없다. 실패하면 retry로 다시 돌고, 사람이 clear를 누르면 또 돌고, 백필을 걸면 지난 날짜로 한꺼번에 돈다. 그때마다 행이 두 배가 되거나 엉뚱한 날짜를 처리하면, 스케줄러가 아무리 잘 돌아도 데이터는 틀린다. 그래서 태스크는 데이터베이스 트랜잭션처럼 다뤄야 하고, 다시 돌려도 같은 결과를 내...
BIGINT 마이크로초 컬럼에 Iceberg day 파티션을 걸 수는 없다. 스펙의 day 변환은 date와 timestamp 계열만 받는다. 정수 epoch를 그대로 쌓아 둔 테이블이라면 파티션을 정하는 순간부터 선택지가 줄어든다. 이 차이를 이해하려면 Iceberg가 테이블을 어떻게 기록하는지부터 봐야 한다. 버전은 Iceberg 1.12와 스...
같은 테이블, 같은 기간을 조회하는데 WHERE 절 모양만 다르면 스캔량이 크게 달라질 수 있다. Superset epoch_us 글에서 계산 컬럼을 쓰면 Athena로 가는 필터가 from_unixtime(created_at / 1000000) >= TIMESTAMP '...'로 나가고, 원하는 모양은 created_at >= 178934...
Kafka 컨슈머가 죽었다가 다시 뜨면 이미 처리한 메시지를 또 받거나, 받기만 하고 처리하지 못한 메시지를 건너뛴다. 어느 쪽이 되는지는 처리와 오프셋 커밋의 순서가 정한다. 이 글은 파티션, 키, 컨슈머 그룹, 오프셋 커밋, 세 가지 전달 보장을 이 순서 문제 하나로 묶어 정리하고, 내가 쓴 글 세 편을 예로 든다. 버전은 Kafka 4.4 기준이...
광고 클릭을 IP별로 세어 짧은 시간에 클릭이 몰린 키를 차단 후보로 쌓는 Flink 잡을 예로 든다. 이런 잡은 워터마크 없이 슬라이딩 처리 시간 윈도로 시작하기 쉽다. 설정이 단순한 대신 재시작 때 백로그가 현재 윈도에 몰린다. 이 선택이 무엇을 얻고 무엇을 내주는지 Flink의 시간 개념으로 풀어 본다. 버전은 Flink 2.3 기준이다. 처...
연말 결산 화면은 사용자 한 명에게 “올해 가장 많이 들은 앨범, 계절별로 많이 들은 곡, 가장 많이 들은 날, 장르 비율” 같은 것을 한꺼번에 보여 준다. 화면을 열 때마다 1년 치 재생 로그를 사용자별로 집계하면 응답이 너무 늦다. 이 잡들은 항목을 전부 미리 계산해 HBase에 넣어 두고, API는 사용자 한 명의 결과를 한 번에 읽기만 한다. ...
이전 회사의 커머스 광고 플랫폼에서 서비스 아홉 개를 한 저장소에서 빌드하고 배포하는 구조를 맡았다. Spring Boot 서비스, Flink 잡, Python 배치, React 관리 화면, 메신저 봇이 한 저장소에 같이 있었고, 환경은 dev, stage, prod 세 개였다. 공통 모듈 하나를 고치면 그걸 쓰는 서비스가 전부 다시 배포돼야 했다. ...
이전 회사의 커머스 광고 플랫폼에서 광고 리포트 배치를 맡았다. 광고주별 하루 사용 내역을 DB에 쌓는 잡은 Spring Batch로 만들었고, 쿼리 결과를 메일과 다른 서비스 API로 보내거나 외부 파트너의 리포트 파일을 옮기는 잡은 EMR에 Spark 스텝으로 올리는 Kotlin 잡으로 만들었다. Spring Batch 쪽은 실행 기록을 DB에 남...
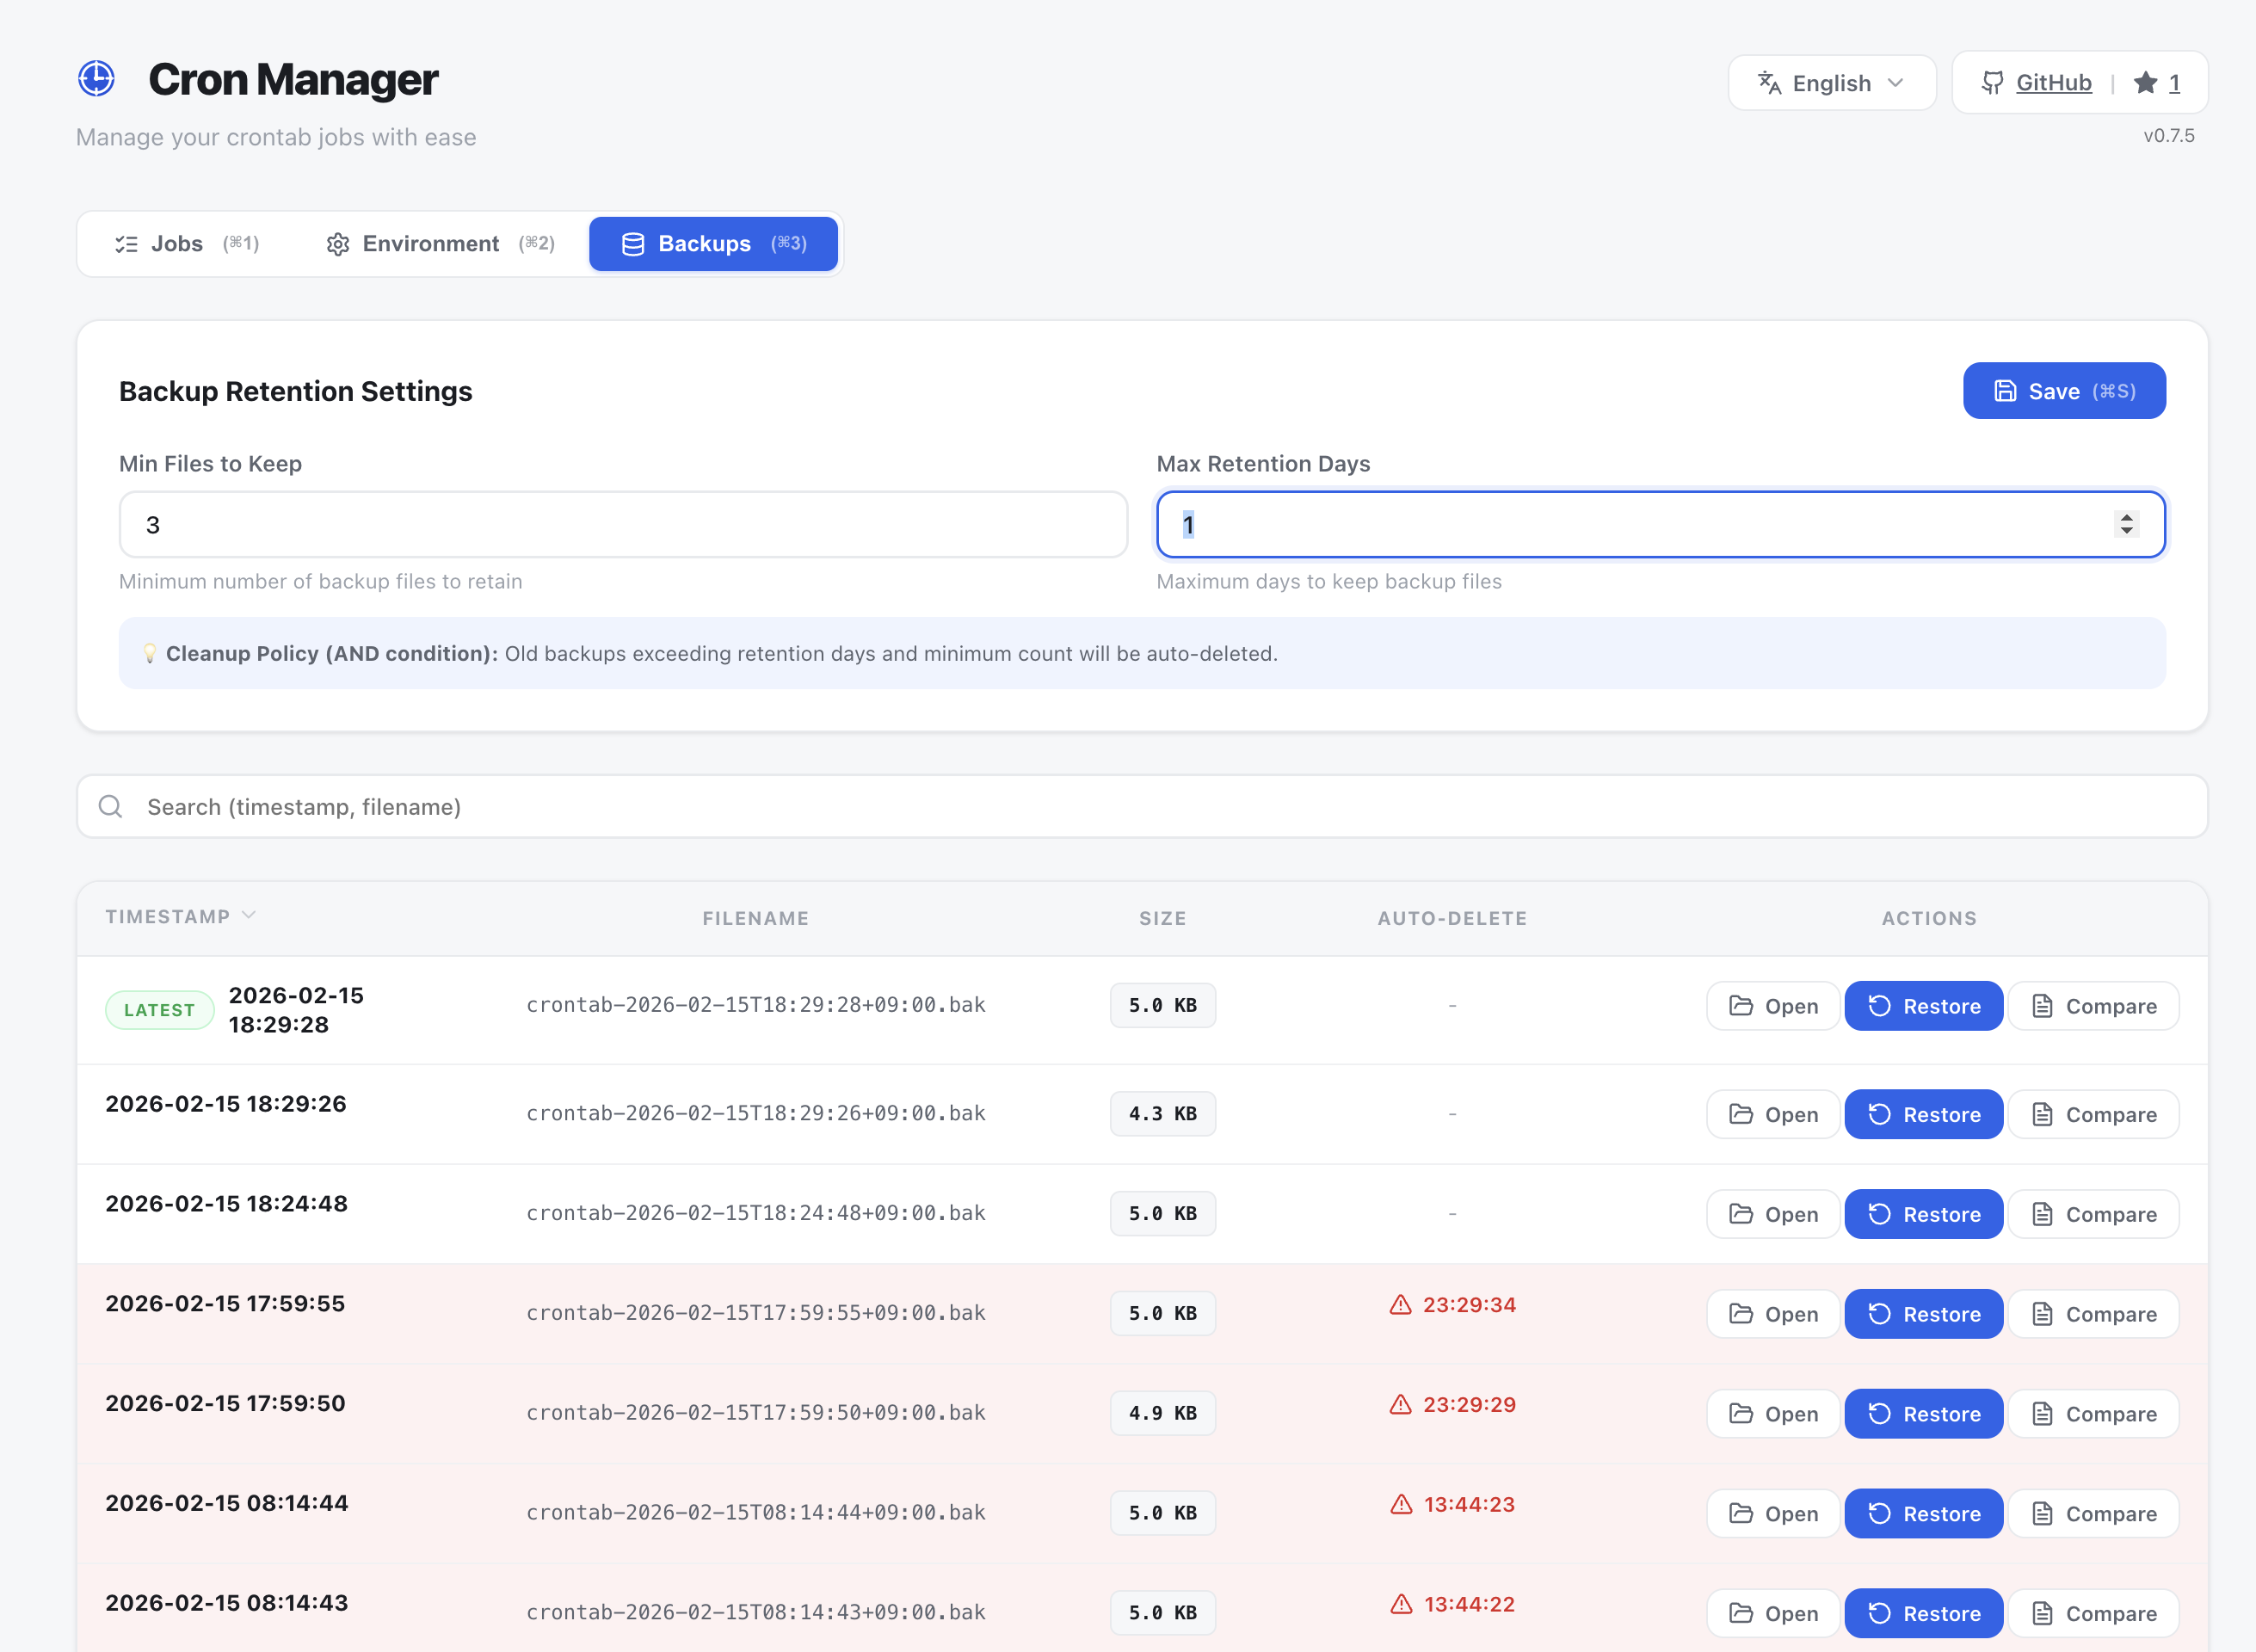
crontab은 사용자마다 파일 한 장이다. 고치는 방법은 crontab -e로 편집기를 열거나 crontab <파일>로 새 내용을 통째로 설치하는 것뿐이고, 이전 내용은 어디에도 남지 않는다. 작업 이름, 설명, 로그 경로를 적어 둘 자리도 따로 없다. cron-manager는 이 파일을 GUI로 다루는 Electron 데스크톱 앱이다....